

UltraEval-Audio:音频AI研究者的革命性工具
音频AI评估的新标杆
音频技术领域迎来了更智能的解决方案。研究人员现在可以使用UltraEval-Audio——这是由清华大学NLP实验室、OpenBMB和Miga Intelligence合作开发的综合评估框架。这不仅仅是一个测试工具;它正在重塑我们评估音频模型的方式。
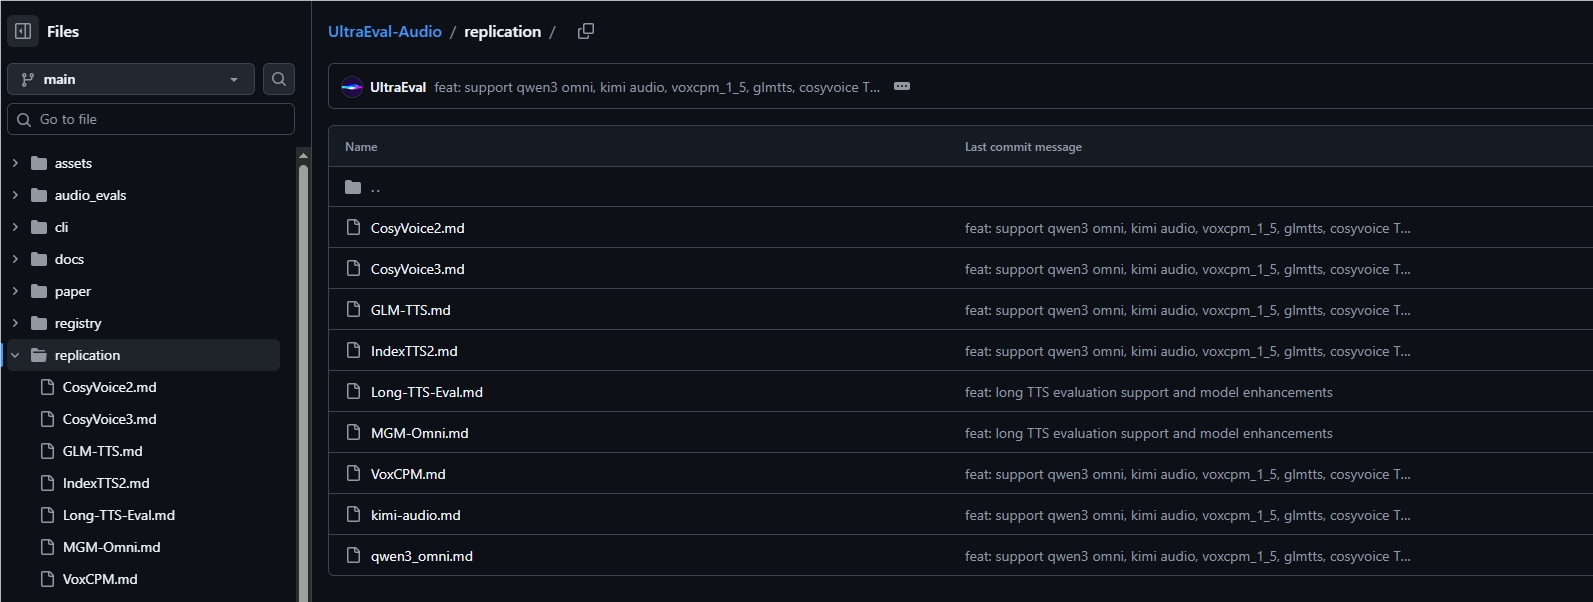
UltraEval-Audio的独特之处?
1.1.0版本在原有功能基础上进行了显著升级:
- 为热门音频模型提供一键复现功能
- 扩展了对专业应用的支持,包括:
- 文本转语音(TTS)
- 自动语音识别(ASR)
- 编解码器(Codec)
- 新增隔离推理执行机制,降低了模型复现的门槛
该框架不仅测试模型——还使整个评估过程更加可控和便携。对于那些在复杂的音频模型评估中挣扎的研究人员来说,这可能是一个救命稻草。
为何此刻如此重要
音频技术正在飞速发展,但这些复杂模型的评估却仍然依赖手动操作且缺乏一致性。UltraEval-Audio通过提供以下功能改变了这一现状:
- 标准化的测试协议
- 更便捷的模型比较方式
- 更可靠的性能指标
项目的开源性质意味着任何人都可以进一步完善这些评估方法。
更广阔的前景
UltraEval-Audio并非孤立运作——它已经成为多个高影响力音频和多模态模型的首选工具。随着采用率的增长,我们可能会看到:
- 音频AI的创新周期加快
- 跨研究的基准测试更加可靠
- 研究成果的可复现性提高
其影响不仅限于学术界——开发语音助手、有声读物旁白系统或自动转录服务的公司都可以从这些标准化评估方法中受益。
关键要点:
- 简化工作流程:一键操作取代复杂的设置过程
- 更广泛的兼容性:支持包括TTS和ASR在内的多种音频模型类型
- 降低门槛:使更多研究人员能够进行高级模型评估
- 开放生态系统:通过GitHub仓库实现社区驱动的改进
The project is available at: UltraEval-Audio GitHub