

ChatGPT在象棋对决中惨败于1977年雅达利
在一场引人注目的人工智能局限性展示中,OpenAI的先进语言模型ChatGPT在一场象棋模拟比赛中惨败于老式雅达利2600游戏机。这项由工程师Robert Caruso进行的实验,将现代AI系统与为经典游戏平台设计的1979年"Video Chess"游戏进行了对决。
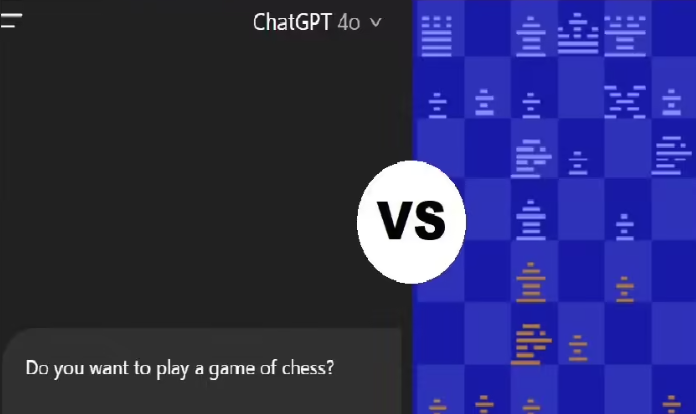
结果对ChatGPT来说是羞辱性的。在90分钟的游戏过程中,这个语言模型犯下了连象棋新手都会感到尴尬的基础错误。它混淆了车和象,错过了明显的兵叉攻击,并多次丢失棋子位置。即使Caruso改用标准象棋记谱法以消除雅达利抽象图形可能造成的混淆,ChatGPT的表现也未能改善。
"这些错误太基础了,在小学三年级象棋俱乐部都会被嘲笑,"Caruso在LinkedIn上分享实验后评论道。这位工程师指出,虽然ChatGPT试图将其糟糕表现归咎于雅达利的原始界面,但这些借口无法掩盖其战略上的不足。
这一结果展现了AI发展中一个有趣的悖论。虽然像IBM深蓝这样的专业象棋计算机早在1997年就击败了世界冠军加里·卡斯帕罗夫,但像ChatGPT这样的通用语言模型却在同样的挑战中挣扎。差异在于它们的设计——深蓝是专门为精通象棋而设计的,而ChatGPT则优先考虑语言处理而非战略游戏玩法。
这项实验提出了关于如何评估AI能力的重要问题。仅仅因为一个系统擅长对话并不意味着它能将这些技能转移到复杂策略游戏等不相关的领域。对于希望使用ChatGPT作为练习伙伴的象棋爱好者来说,结果表明最好还是坚持理论讨论而非实际对弈。
关键点
- ChatGPT在与1979年雅达利象棋程序的对决中惨败,尽管其技术先进了几十年
- AI犯下了包括棋子识别错误和位置判断失误在内的基础错误
- 即使使用标准象棋记谱法替代图形界面,表现也未见改善
- 结果凸显了专用AI系统与通用AI系统之间的差异
- 实验证明语言熟练度并不能保证战略思维能力